起心动念
首届恋爱黑客松——这五个字往桌上一放,我就知道要动手了。
一个专门给“恋爱”这件事开的黑客松,本身就是一件挺浪漫的事情:一群理工科的、平时忙着写代码调模型的人,被拉到同一个题目下讨论“人和人怎么好好在一起”。这个赛道足够新,也足够真诚。
命题一出来,我脑子里第一个冒出来的念头是:别再做一个“更聪明的 AI 聊天机器人”了。
朋友们,坦白讲,2026 年的相亲/交友市场,最不缺的就是“AI 帮你聊天”。你给它一张对方的照片,它能编一段土味情话;你给它一句“晚安”,它能接一段莎士比亚。可是——
然后呢?
聊得再好,见面还是尴尬。因为聊天的那个人,从来就不是你。
名片 vs 博物馆
我们这一代人的自我介绍,早就“名片化”到骨子里了。
打开任何一款交友软件,你看到的都是同一张二维名片:
姓名 · 年龄 · 身高 · 学历 · 年薪 · 城市 · 爱好列表 · 三张精修照片
**这是一个人吗?**这最多是一张海关申报单。
海关申报单能告诉你这个人**“是什么”**,但没法告诉你 TA “怎么想”。你没法从“身高 175”里推出 TA 在冲突里是先说狠话还是先转身走;没法从“爱好:旅行、电影”里读出 TA 会不会为了陪读放弃自己的事业;没法从年薪那一栏里知道 TA 到底是“细水长流型”还是“及时行乐型”。
所以我想做的事情,是从二维名片里,把一个人立起来。
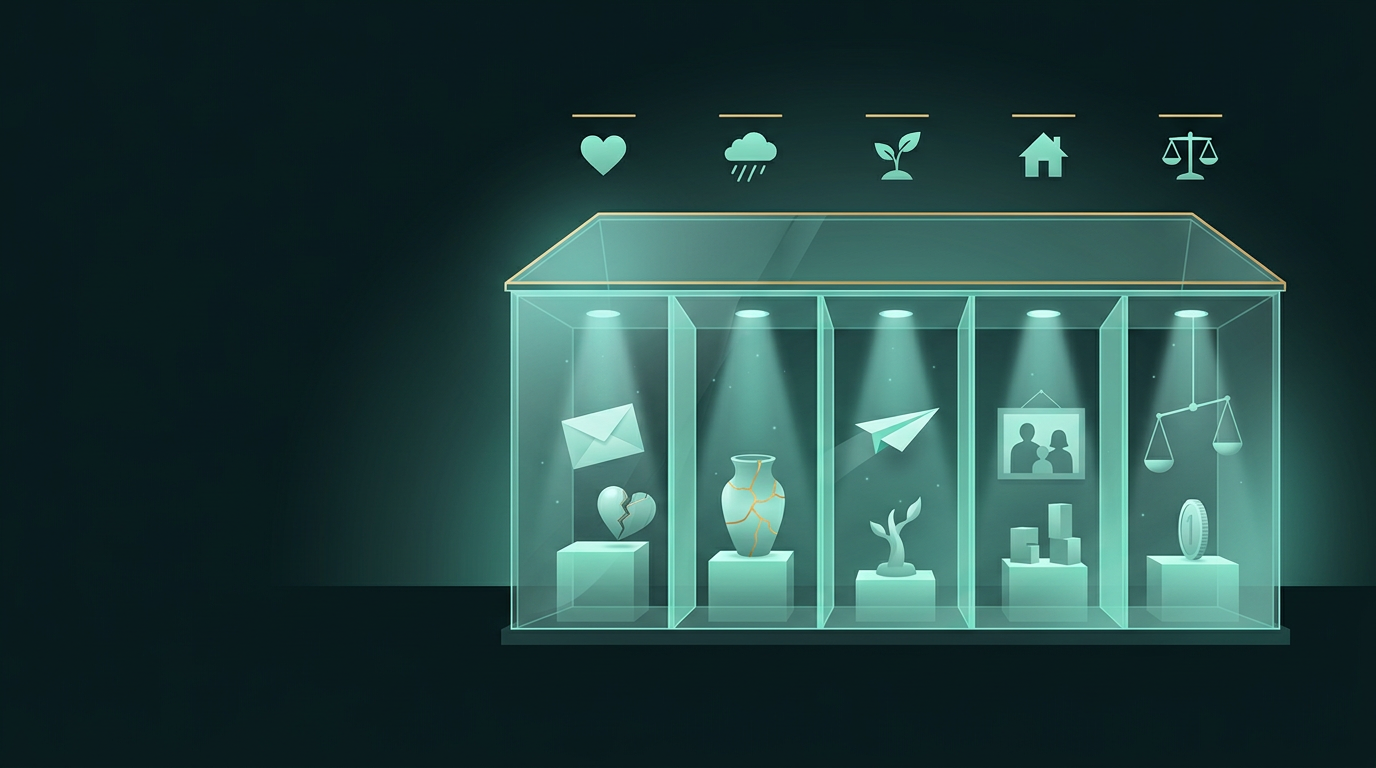
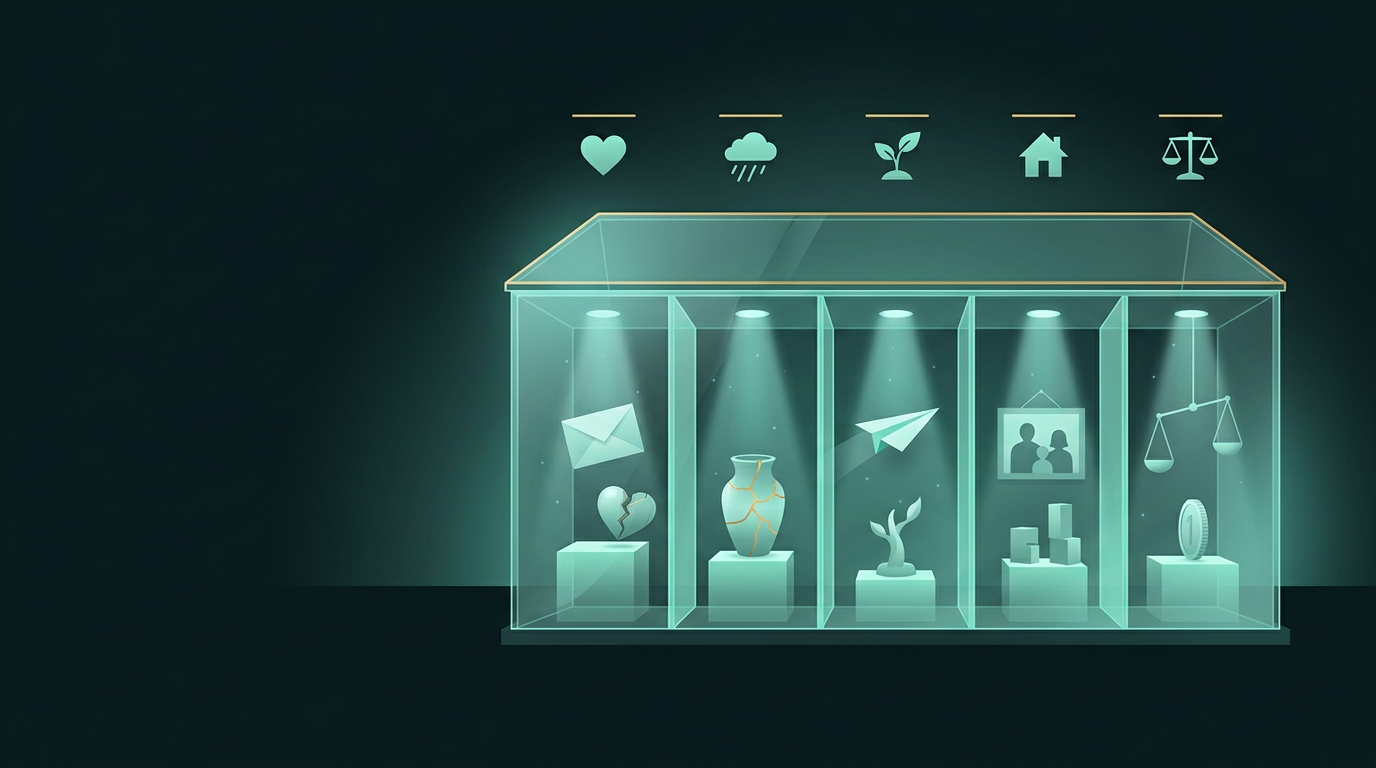
一个真实的人是三维的。TA 是一座人生博物馆:
- 每一段经历,都是一件展品
- 每一个态度维度(亲密关系、冲突、成长、家庭、金钱),都是一个展厅
- 每一句“我曾经这样、现在这样、以后大概还会这样”,都是展品旁边的那张说明卡
- 而你自己——你是这座博物馆唯一的策展人
相亲/交友这件事,真正该发生的动作,不是“翻名片”,而是走进彼此的博物馆。两个人的展品对上眼,你走到 TA 的“摩擦与冲突”展厅前发现“哦她也是选择先冷静再说清”,那一刻的共鸣,比“我们都爱旅行”这种话头厚重一百倍。
AI 在这件事里的正确位置,从来不是“替你聊天”——是当你的布展师。
它蹲下来跟你讲故事、抛问题、翻你嘴里那些自己都没意识到的经历,然后把它们打灯、上标签、码进对应展厅。展厅盖好了,剩下的对话,是你自己的事情。
这就是「人生 Attitude 册子」的立意。仓库地址是 guanlili/LifeAttitudeBooklet。
一句话产品定位
面向 18-35 岁追求长期真诚关系的人群:AI 用渐进式小故事引导你表达人生态度 → 沉淀为一座属于你的「Attitude 册子」(你的私人博物馆)→ 复用于匹配推荐、破冰话题、长联触达。
四条原则,写在 README 的第一行,也写在每一个 prompt 的最前面:
- 真实真诚不娱乐化 — 不整活、不土味情话、不打颜值分
- 无痛引导 — 每次会话短、每轮一问,不批量灌问卷
- 态度优先 — 沉淀的是“你怎么看”,不是“你多有钱、身高多少”
- 真人主导 — AI 只辅助,不代聊、不替你做决定
第四条最不像 2026 年一个 AI 产品会写的话。但它是这座博物馆的灵魂——博物馆的价值,从来不在讲解员讲得多好,而在展品是不是真的。
用户旅程:AI 在博物馆里的五个岗位
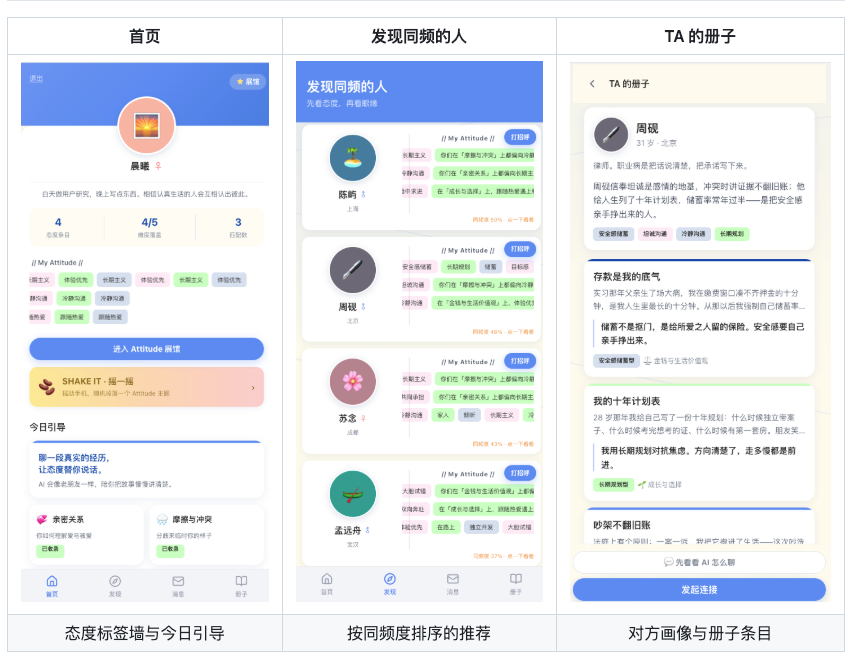
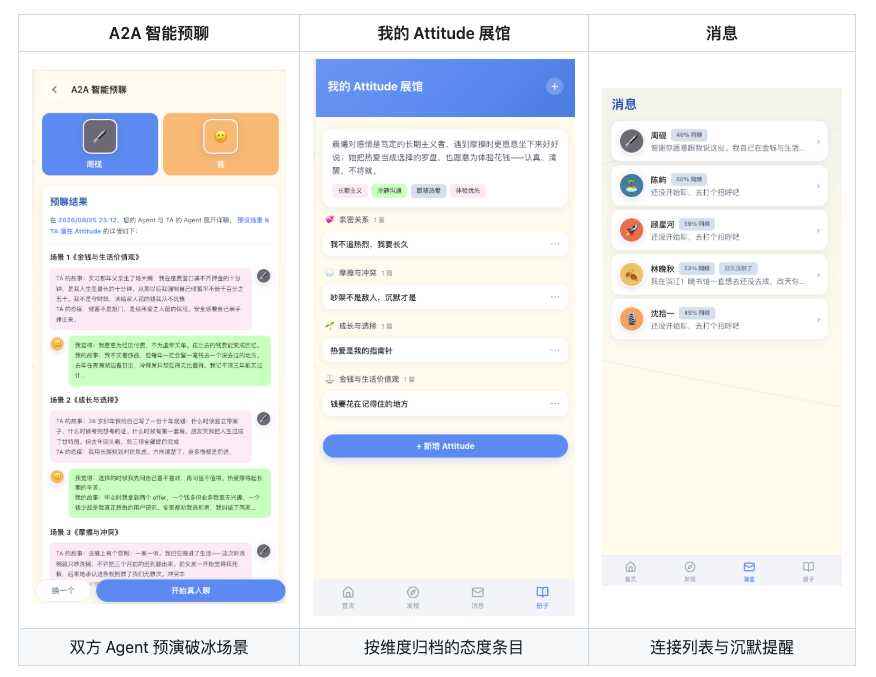
产品拆开来看,其实就五个场景,AI 在每一个场景都有明确的、极其克制的分工。我用博物馆的隐喻把它们串起来:
场景 1:布展师(AI 讲故事 + 抛问题)
用户选一个展厅(我抽象成 5 个维度:love / conflict / growth / family / values,对应亲密关系、摩擦冲突、成长选择、家庭承诺、金钱价值观),AI 用一个 60-120 字的真实生活化小故事破冰,然后抛出第一问。
关键约束:每轮只问一个问题、不超过 50 字、不给建议、不代替用户总结。
为什么这么克制?因为一旦 AI 开始“总结”你,用户就会开始“迎合” AI——这在心理学上叫 anchoring,是所有基于聊天的态度采集工具的原罪。我做了两轮用户测试,发现 AI 每多说一句“我理解你的意思是……”,用户下一句就会变得越来越像 AI 想听到的样子。
一个称职的布展师,不会替艺术家解释作品的意义。TA 只负责把光打对。
所以 prompt 里死死写着:只共情一句 + 追问一句。
场景 2:上展品(从对话里提炼一条册子条目)
对话进行到用户表达清晰了(大约 3-5 轮),AI 做一次结构化提取——把这场对话打包成博物馆里的一件展品:
{
  "title": "有话摊开说",
  "story": "我经历过一段有话不说的关系……现在的我宁可当场吵一架,也要把话摊开。",
  "attitude": "憋着才伤感情,坦诚地把话说开,是我用一段关系换来的答案。",
  "stance": "坦诚沟通型",
  "tags": ["坦诚", "摊开说"],
  "depthLevel": 3
}title是展品的名字story是展品本身(用户口述的经历改写成第一人称)attitude是展品旁边的说明卡stance是展品被归入的分类标签depthLevel1-3 是这件展品被摆在哪个位置——是玄关随手一挂(1),还是主展厅 C 位(3)
看到 stance 那个字段了吗?它不是 AI 自由发挥的。 它必须从我写死的一份“立场词表”里选一个——每个维度大概 15-25 个规范立场,比如亲密关系维度里有“坦诚沟通型”“高质量陪伴型”“慢热磨合型”“高频情感反馈型”等等。
为什么要这么设计? 因为下一步的匹配算法要用它做集合运算——“坦诚沟通型”和“坦诚型”在人眼里是一样的,在 Set.has() 里就是两个东西。词表化之后,AI 输出的自由度降了 90%,但匹配的稳定性提了 10 倍。
这是我在这个项目里最得意的一个取舍——把 AI 的创造力限制在故事和文案里,把匹配决策交给确定性代码。 布展师可以自由发挥打灯角度,但展品必须归入正确的展厅。
场景 3:博物馆序言(画像总结)
有了几件展品之后,AI 用第三人称写 40-80 字,作为整座博物馆的入口序言:
“晨曦是一个在亲密关系里选择坦诚摊开的人,她相信慢热磨合胜过一见钟情,也认为家庭承诺不是一句话能替代的责任。”
约束:真诚具体、不堆砌形容词。我 prompt 里写了一句话:“不要用’温暖’‘美好’’独特’这种正确废话。”
好的博物馆序言从来不会写“这是一座伟大的博物馆”——它会写“这座博物馆讲了一件事”。
场景 4:跨馆对望(匹配理由 + 破冰话题)
两个用户匹配的时候,本质上是两座博物馆开始互相参观。AI 干两件事:
- 生成 2-3 条匹配理由(30 字以内,基于立场共鸣或有张力的互补)——两座博物馆里摆着同款展品的那些位置
- 生成 恰好 3 个破冰话题(40 字以内)——站在共同展品前可以起的头
核心约束:绝对不泄露对方册子里故事的任何原文细节。 AI 只能看到“立场标签”,看不到“故事正文”。
这条约束是我做产品测试时才补上的——第一版 AI 会热情地写:“我看你们都经历过感情里的沟通问题……” 大姐,那是用户的隐私啊!
博物馆的介绍词,只能讲展品分类,不能讲展品内容。 内容是策展人自己走过去讲的。
场景 5:新展厅通知(长联触达)
沉默一段时间后,AI 帮你代拟一条重新联系的消息——代拟,不是代发。
三种触发场景:
- 对方在某个展厅新加了一件展品(
new_entry)——“你昨天刚加了一件’家庭承诺’的展品,我想过去看看” - 双方在同一个展厅立场相近(
resonance)——“我发现我们的’成长选择’展厅摆得很像” - 单纯沉默太久(
silence)——“好像很久没在你的展厅里走过了”
60 字以内、不卑微不油腻、给对方一个容易接的话头。
这里就是我说“真人主导”最较真的一处:AI 可以写草稿,但按下“发送”的那只手,永远是你。博物馆可以自动推送新展讯,但走不走过来,是访客自己决定。
三个工程取舍
这个项目 48 小时能跑起来的核心,是三个为了 Demo 不翻车做的决定。
取舍一:真实 AI + Mock 双通道,全场景可离线演示
黑客松最怕什么?你的 API 挂了。
所以我一开始就做了个决定:7 个 AI 场景,每一个都要有确定性 Mock 兜底。
架构长这样:
// server/src/ai/index.ts
async function callReal<T>(pair: PromptPair): Promise<T | null> {
  if (aiMode !== 'real') return null;
  try {
    const text = await chatCompletion([
      { role: 'system', content: pair.system },
      { role: 'user', content: pair.user },
    ]);
    return parseJson<T>(text);
  } catch (err) {
    console.warn('[ai] 真实 AI 调用失败,回落 mock:', (err as Error).message);
    return null;
  }
}

export async function extractEntry(dimension, messages) {
  const fallback = mock.extractEntry(dimension, messages);
  const real = await callReal(prompts.extractEntry(dimension, messages));
  // 任何字段脏了,整体回落
  if (!real || !STANCES[dimension].includes(real.stance)) return fallback;
  return { ...merged };
}
翻译一下:
- 没配 API Key?走 Mock,全功能可用
- 配了 API Key 但接口挂了?走 Mock,用户无感
- API 通了但 JSON 解析失败?走 Mock
- JSON 解析成功但
stance不在词表内?走 Mock
Mock 不是“降级方案”,Mock 是我的护身符。 它跟真实 AI 输出同一份数据契约,前端根本不知道自己拿到的是 GPT-5 还是我写的 if-else。
用博物馆的话说:布展师请假了,我还有一份手写的备用讲解词。参观体验不会中断。
Demo 那天上午我 API 额度果然被烧完了,评委面前丝滑演示,无一处报错——这个决定,值回票价。
取舍二:匹配算法一行 AI 都没有
我知道 2026 年做 AI 项目不用 AI 做核心决策会被人喷“你这也叫 AI 产品?”,但我杠就是你对。
匹配算法我用了确定性纯函数:
score = 0.6 × 加权 Jaccard(立场集,权重按 depthLevel/3)
      + 0.3 × 维度 Jaccard
      + 0.1 × min(1, 对方条目数/5)
翻译成人话:
- 60% 权重看立场重合度——两座博物馆摆着多少同款展品
- 30% 权重看维度覆盖——两座博物馆开了多少个相同展厅(避免“半个博物馆”和满馆匹配)
- 10% 权重看对方条目数——博物馆里到底摆了几件东西(避免“空展厅”骗匹配)
- 深度加权——同一件“坦诚沟通型”展品,摆在玄关(depthLevel=1)和摆在 C 位(depthLevel=3)在匹配里权重差 3 倍
为什么不用 AI 直接算相似度? 因为 AI 的输出每次都不一样。同一对用户上午匹配是 87 分,下午变 82 分,用户会怀疑人生。匹配这种关乎信任的核心决策,必须可解释、可复现、可回滚。
AI 只负责把匹配理由翻译成人话。计算是我算的,讲故事交给它。
取舍三:立场词表 + JSON 输出 + 双重校验
前面提过的 stance 词表。放在这里再展开一次,因为它是整座博物馆能稳定运转的地基:
- AI 的 prompt 里显式列出“必须从这些词里选一个”
- AI 输出后,代码里再校验一次
STANCES[dimension].includes(real.stance) - 校验失败整条丢弃,回落 Mock
双重校验的意义:LLM 就算被明确告知只能从 20 个词里选,也会偶尔冒出个“温柔坚定型”这种词表里没有的新词。这个词单看很好听,但塞进匹配算法里就是脏数据——它跟“坚定型”和“温柔沟通型”都不匹配,会污染整个用户的匹配池。
博物馆的分类学,必须由策展总监拍板,不能让每个布展师现场生造。
结论:不要相信 AI 的自律,要相信代码的校验。
踩坑实录:gpt-5 把我的 10 秒超时打爆了
第二次 commit(09f7963)你猜是干嘛的?
feat: 接入真实 AI,将 AI 请求超时从 10s 调整为 90s(适配 gpt-5 推理模型)
血泪史。
第一版我信心满满地把超时设成 10 秒——毕竟 gpt-4o-mini 平均响应 2-3 秒,10 秒的余量已经很宽了。上线切 gpt-5 那天,前端一片红。
gpt-5 是推理模型(reasoning model),它会先“想”再答。 “想”这个过程,普通问题也要 15-30 秒,复杂 prompt 直接 60 秒起步。10 秒对它来说,约等于让博尔特起跑 3 米就撞线。
改成 90 秒之后一切正常。但代价是:如果真实 AI 卡满 90 秒最后失败,用户等了整整一分半才看到 Mock 兜底的内容——体验灾难。
所以我加了一个额外的规则:前端在等待 AI 时展示“正在为你构思……“的骨架屏,超过 8 秒开始滚动小故事。用产品的耐心,去接工程的等待。博物馆的门开着,你先在前厅看几幅速写,正厅的灯还在打。
教训:推理模型的超时策略必须做两层——一层是 client 的骨架屏节奏,一层是 server 的 hard timeout。
用了 AI 之后,反而更想守住“人”的部分
写完这个 side project 之后我最大的感受是——
AI 越强,你越要想清楚 AI 不该做什么。
我可以让 GPT-5 帮用户“生成完美的第一次约会话术”,那样 Demo 会更炸;我可以让 AI 直接算“你俩契合度 92 分”,那样匹配页更好看。但我不。
因为一段真实的、长期的关系,从来不是靠一段完美话术开始的。它是靠你自己想清楚了自己是谁、对方也想清楚了对方是谁,然后两个“想清楚”的人对上眼。
二维名片解决“是什么”,三维博物馆解决“怎么想”。 前者一秒钟就能滑过去,后者你得走进去、蹲下来、读展品说明卡。
AI 在这个流程里的正确位置是:
- 布展师——帮你打光、码展品,不替你写作品意图
- 序言撰稿人——写一段真诚具体的入口简介,不吹嘘
- 导览员——告诉访客你这里有什么展厅,绝不剧透展品内容
- 展讯推送——新展厅上了帮你发通知,但发不发、来不来,是双方自己的选择
它可以帮你把博物馆盖起来,但它不该假装自己是你。
不代聊、不打分、不娱乐化——这三条克制,是我最想留给这个项目的东西。
尾声:顺便拿了个最佳人气奖
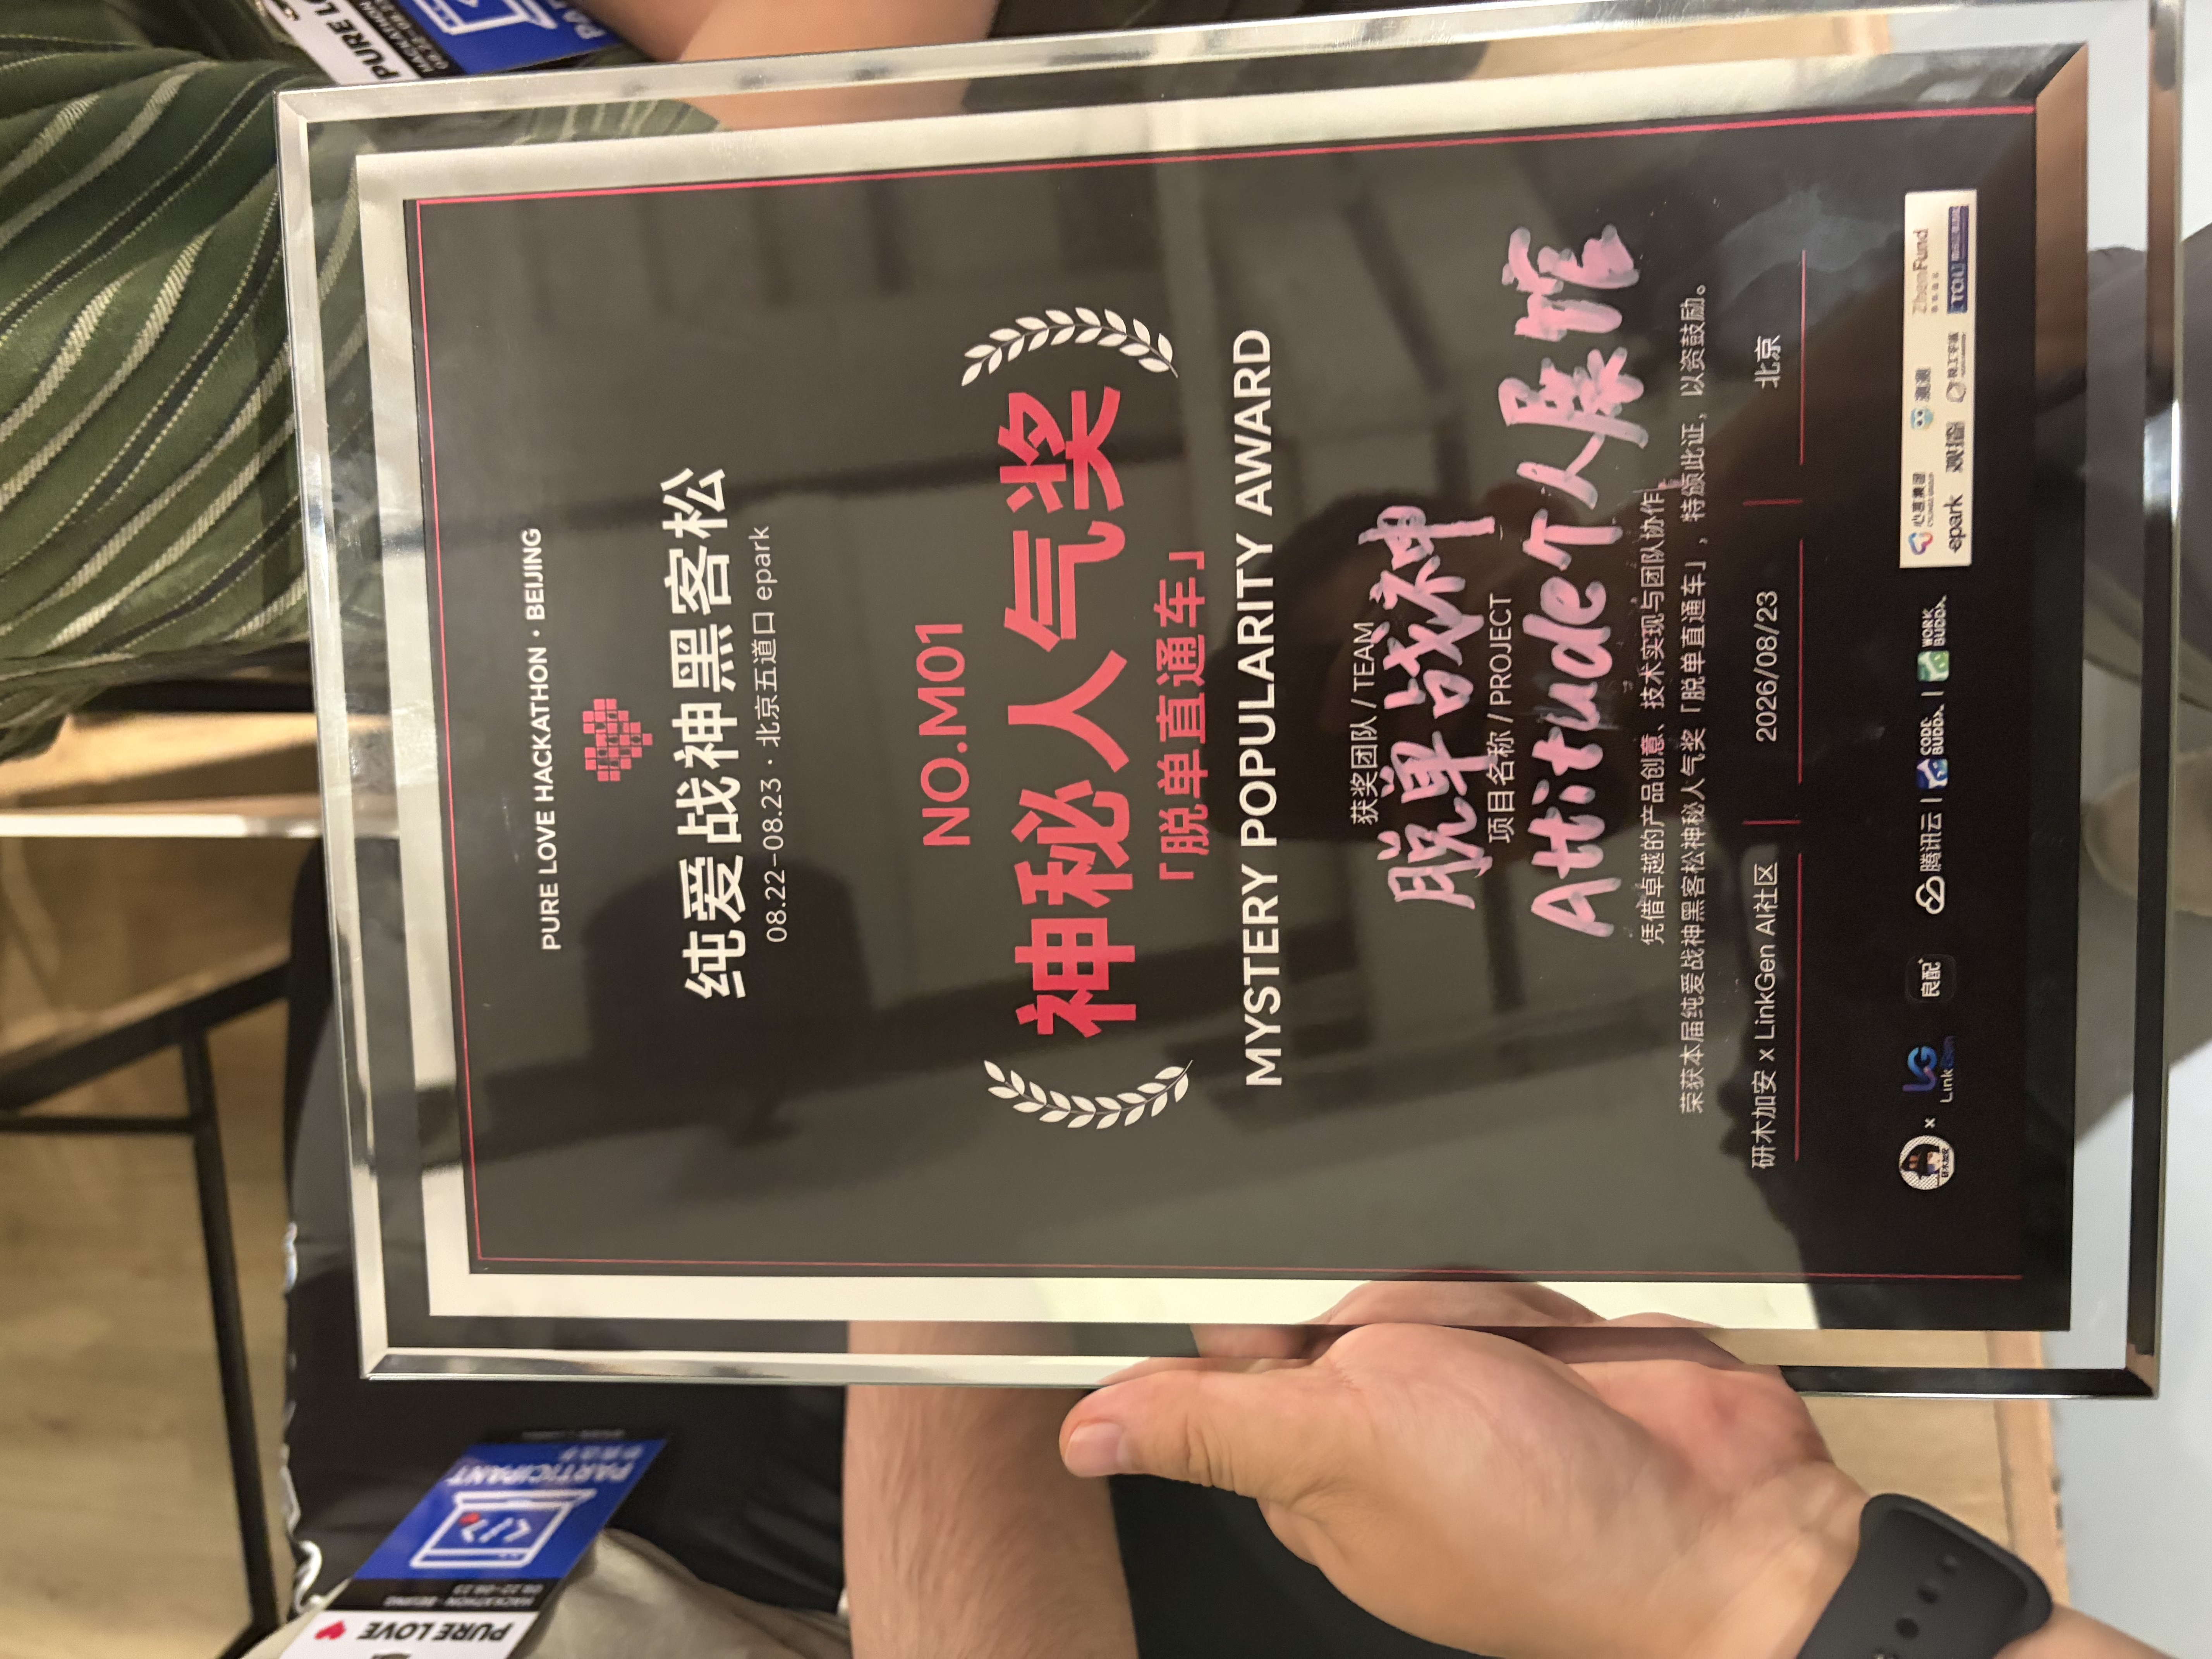
写到这里其实文章可以结束了。但补一笔,因为它挺出乎我意料——这个项目在首届恋爱黑客松上拿了最佳人气奖。
坦白讲,做完那一晚我是有点忐忑的。因为在一堆“AI 帮你写代码”“AI 帮你剪视频”“AI 帮你 XXX”的项目里,我这个东西反着来——AI 什么都不帮你做,只帮你想清楚自己。何况是“恋爱”这个赛道,大家更期待的往往是“AI 帮你追到心动的人”这种即时满足感的方案。评委会不会觉得“你这也叫 AI 产品”?
结果人气奖是大家投出来的。
那一刻我才后知后觉地意识到一件事:其实每个人心里都渴望被当成一座博物馆看,而不是一张名片翻。只是平时没人给这个机会。你在相亲软件上被“175 cm、年薪 30w、爱好旅行”定义了太多次,突然有个东西蹲下来问你“你上一次为一段关系摊开说话,是什么时候”——那种被看见的感觉,是会传染的。
首届恋爱黑客松的人气奖,某种程度上也是一次投票:投票的人在说,恋爱这件事,我们其实想要的不是更花的话术,是更真的自己。
所以——顺便拿了个奖。但真正的奖,是那一堆帮我投票的、认真跟“晨曦”聊过五分钟的陌生人。
遗憾与展望
48 小时的项目,遗憾自然不少:
- 多模态没接——语音输入其实更适合“讲故事”这个场景,比打字更容易松弛(未来的博物馆应该能收藏一段用户的声音展品)
- Long context 没吃透——用户册子多了以后,画像总结应该做成 RAG 而不是一次性喂全部条目
- 反 AI 检测没做——真到线上会有一批用户直接用 ChatGPT 生成“人设”,需要一层反注入(假展品是所有博物馆的敌人)
- 匹配的解释性还能更强——现在匹配理由是“两条一起给”,未来应该做成“逐维度归因”,让访客真正看见“两馆同款展品在哪几个展厅”
但也就够了。48 小时不该追求“做完”,应该追求“把最想说的那句话说清楚”。
我最想说的那句话,其实就一句:
每个人都值得拥有一座属于自己的博物馆,而不是被压扁成一张海关申报单。
收束
有幸这个夏天参加了这场黑客松,逼自己把一个想了很久的 side project 从 idea 变成 git init。仓库还在 guanlili/LifeAttitudeBooklet,欢迎路过的朋友 star 或 fork——但更希望你 clone 下来跑一遍 npm run seed && npm run dev,跟“晨曦”聊上五分钟,看看你在“金钱与生活价值观”展厅里,最后摆出来的第一件展品,会是什么。
那件展品,就是你博物馆的入门票。
你是唯一的策展人。
道阻且长,行则将至。
记于 2026.08.25,一个想清楚的夏末。